AI w reklamach nieruchomości: ocena skryptu przed startem
AI w reklamach nieruchomości: gotowy prompt i rubryka 5 kryteriów do oceny skryptu wideo przed startem. Co AI oceni, a co sprawdzi tylko test na budżecie.
AI oceni skrypt reklamy nieruchomości w kilka minut według 5 kryteriów i odsieje teksty, których nie warto nagrywać, ale nie przewidzi hook rate ani kosztu leada. Decyzję „nagrywać czy nie” daj modelowi z rubryką (próg 4,5 na 5 = nagrywaj), decyzję „skalować czy nie” zostaw testowi na żywym budżecie.
Większość tekstów o AI w nieruchomościach to listy narzędzi do opisów ofert i wirtualnych spacerów. Oczekiwanie, że agent będzie z nich korzystał, już jest: według badania IQS dla Otodom z października 2021 roku 78% klientów oczekuje od agentów korzystania z nowych technologii (N=1000, osoby w wieku 18–55 lat). Ten poradnik dotyczy jednego, wąskiego zadania: jak użyć ChatGPT, Claude albo Gemini, żeby ocenić skrypt reklamy wideo dla sprzedających, zanim biuro wyda pieniądze na nagranie i emisję. Dostajesz rubrykę z wagami, listę czerwonych kartek, pełny prompt do skopiowania i progi decyzji.
Przykładowa sytuacja (ilustracja, nie historia klienta): biuro z czterema agentami ma sześć skryptów reklam do Meta Ads, napisanych przez różne osoby. Budżet i czas wystarczą na nagranie i przetestowanie dwóch. Właściciel wybierałby „na czuja”, czyli najpewniej skrypt, który sam napisał. Zamiast tego wkleja wszystkie sześć do modelu z tym samym promptem i rubryką. Dwa skrypty odpadają od razu (jeden obiecuje „sprzedaż w 14 dni”, drugi nie ma wezwania do działania), trzy dostają 3,0–3,5 z konkretnymi poprawkami, jeden dostaje 4,5. Do nagrania idą: skrypt z 4,5 i najlepszy z poprawionych. Reszta decyzji należy już do testu.
Co AI w reklamach nieruchomości robi dobrze, a czego nie umie?
Model językowy czyta tekst. Dobrze ocenia więc wszystko, co jest w tekście: czy pierwsze zdanie zatrzymuje sprzedającego, czy padają konkrety, czy skrypt da się wypowiedzieć bez zadyszki. Nie widzi natomiast twojej grupy odbiorców, stawek w aukcji, pory emisji ani tego, jak zagra agent przed kamerą.
Dostawca narzędzi do analityki kreacji Segwise ujmuje to w swoim przeglądzie metod testowania przed startem wprost: wynik takiej oceny to „creative potential”, a nie „creative destiny”, a narzędzia AI „don’t replace in-market testing”. To opinia firmy, która takie narzędzia sprzedaje, więc tym bardziej warto ją potraktować poważnie.
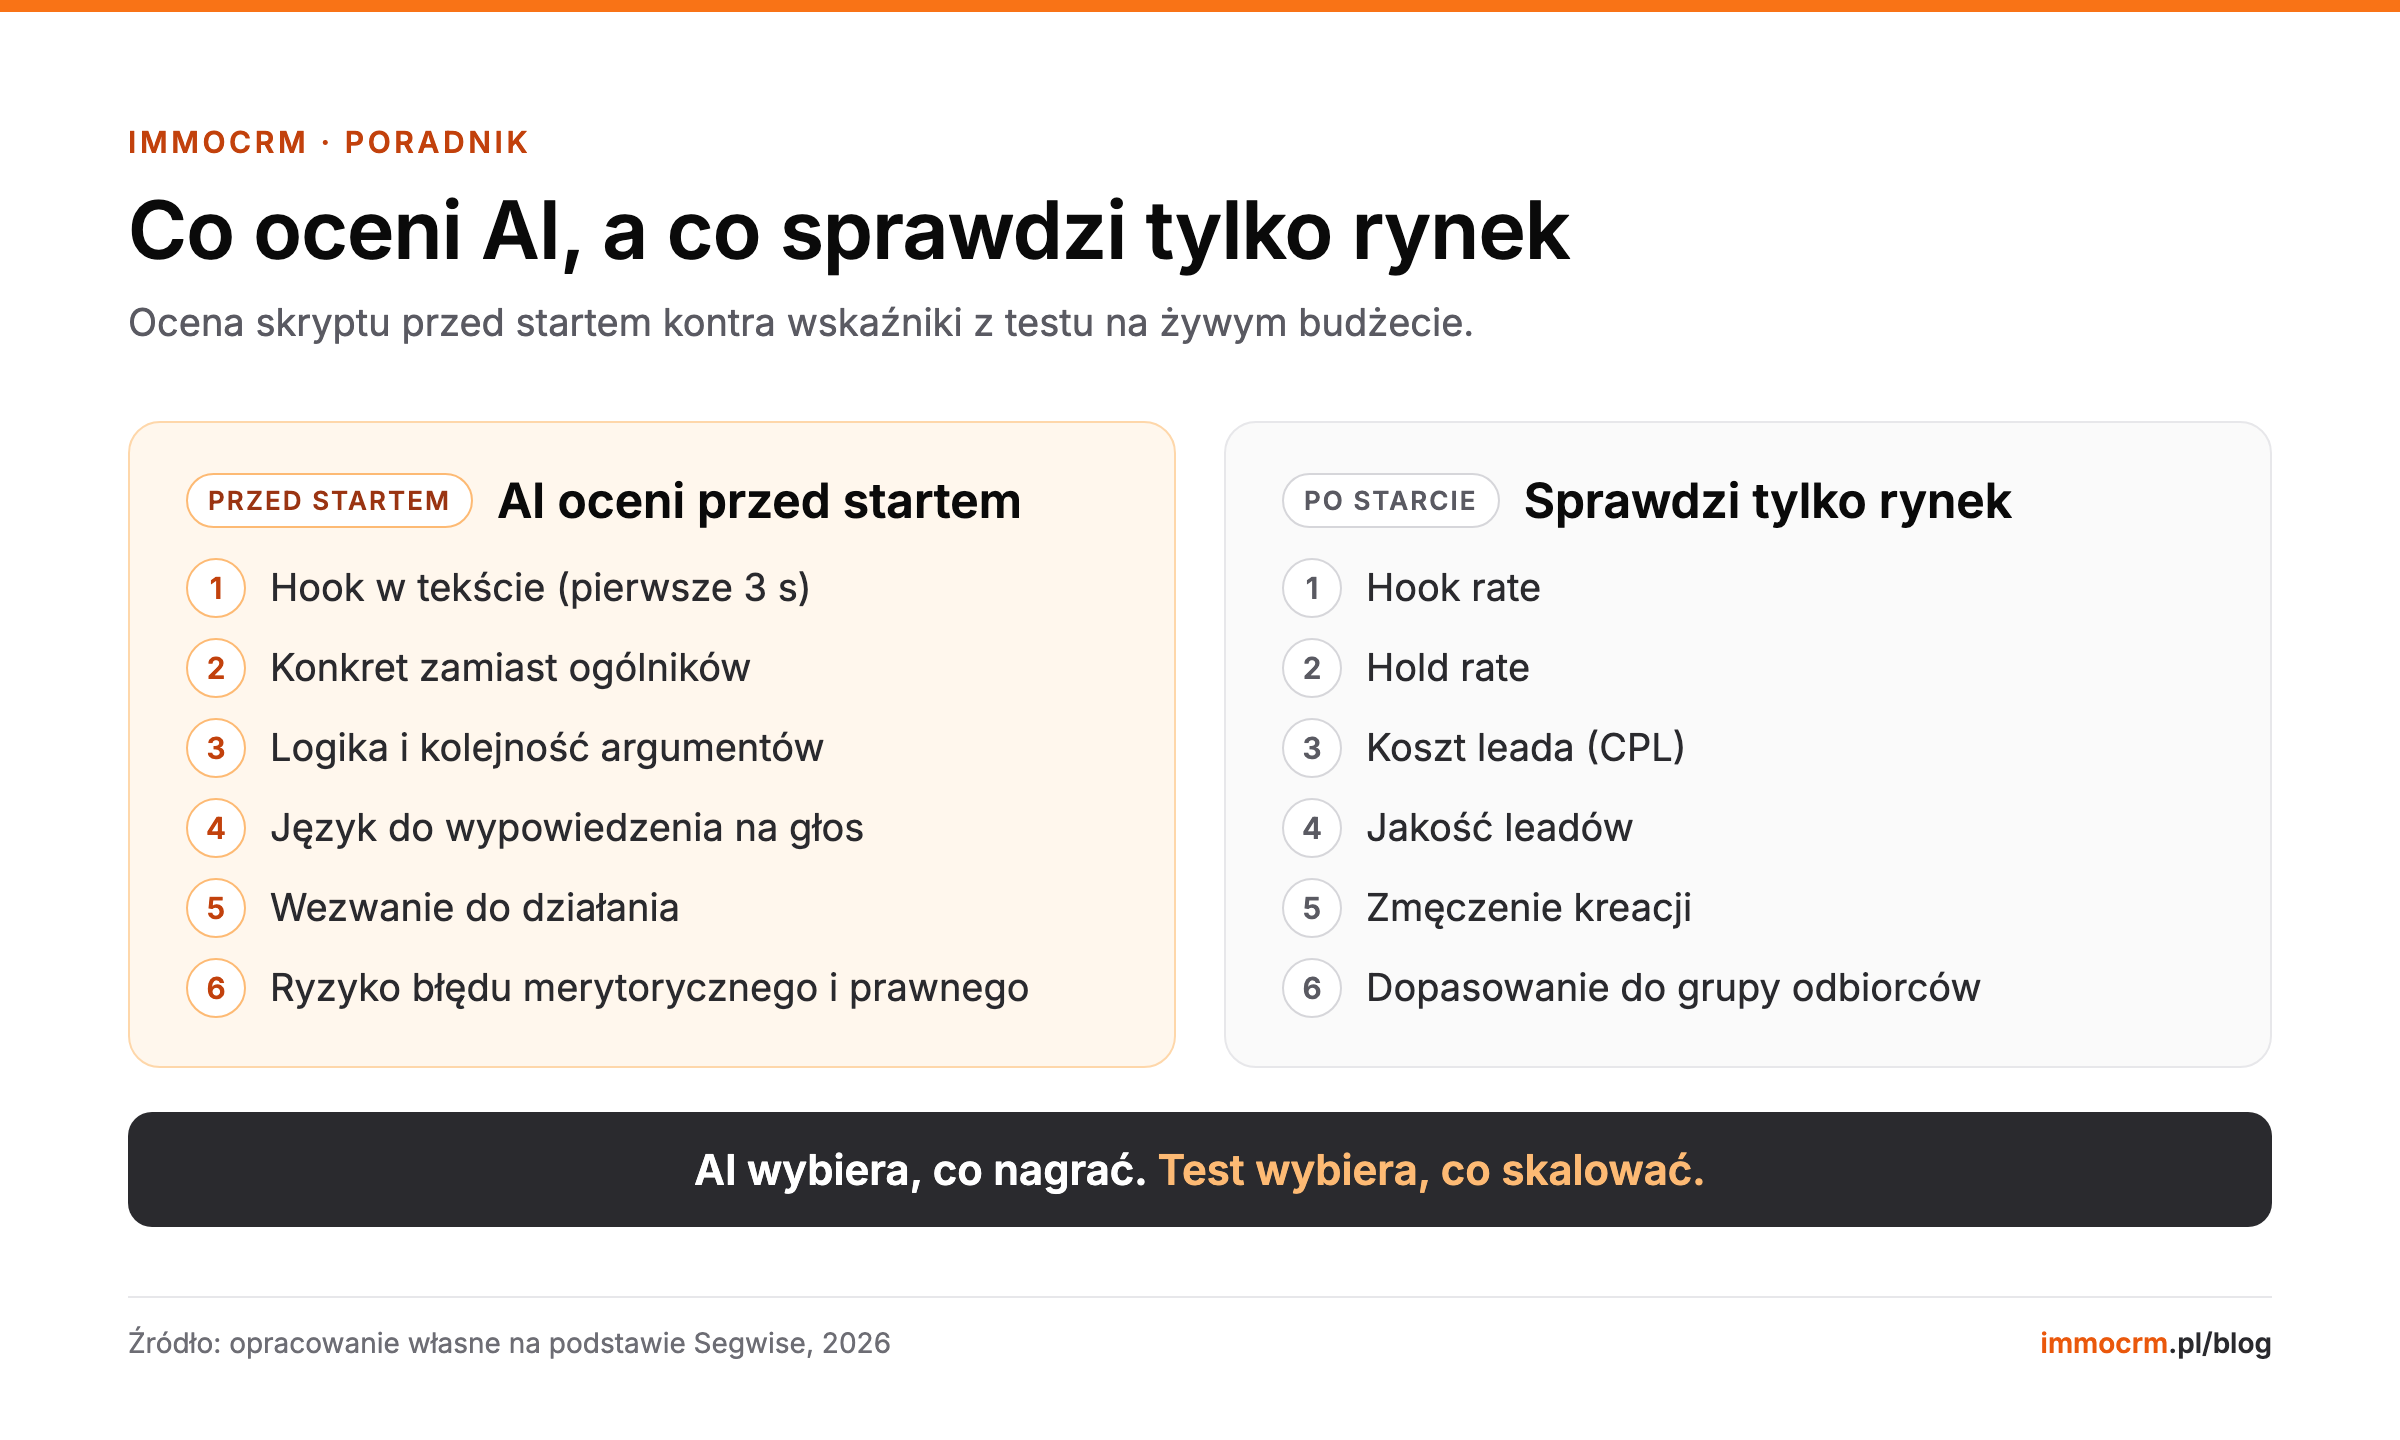
| AI oceni przed startem | Sprawdzi tylko test na budżecie |
|---|---|
| Czy hook w tekście mówi do sprzedającego | Hook rate, czyli ile osób obejrzało pierwsze sekundy |
| Konkret vs ogólniki („sprzedamy szybko”) | Hold rate, czyli ile osób zostało do końca |
| Logika i kolejność argumentów | Koszt leada w danym mieście i grupie |
| Czy tekst da się nagrać naturalnie | Jakość leadów i odsetek spotkań |
| Czy wezwanie jest jasne i filtruje | Zmęczenie kreacji po kilku tygodniach |
| Ryzyko błędu merytorycznego lub prawnego | Czy przekaz trafia do tej konkretnej grupy |
Wniosek praktyczny: AI jest sitem, nie wyrocznią. Ma odsiać słabe teksty tanio i szybko, a nie wskazać zwycięzcę.
Rubryka: 5 kryteriów oceny skryptu reklamy
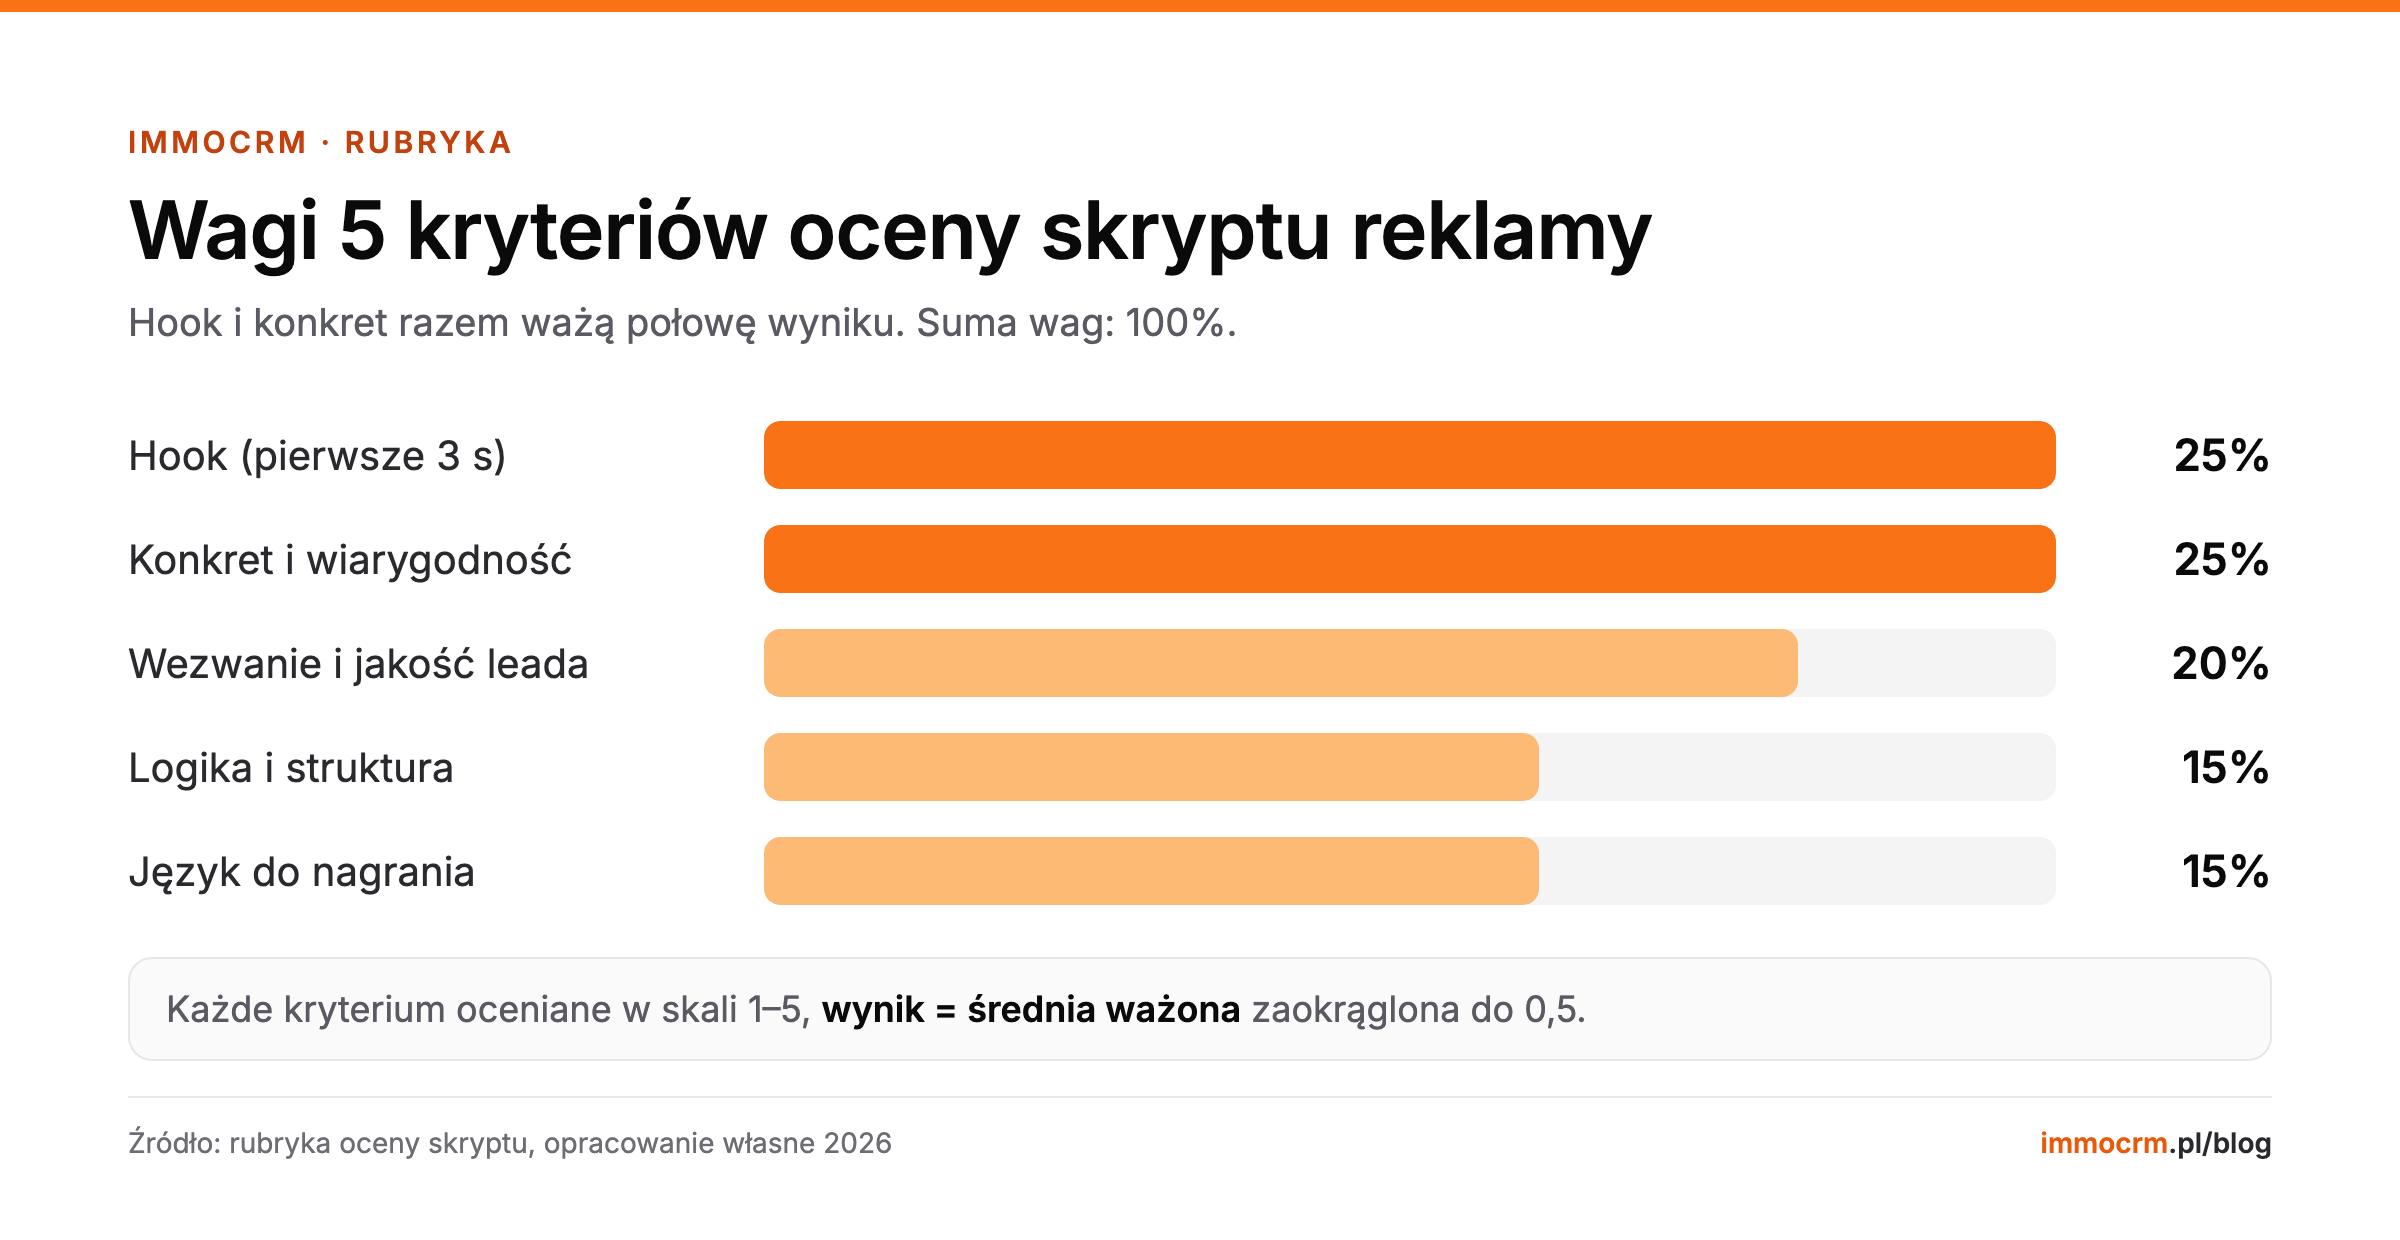
Bez rubryki model ocenia „ogólne wrażenie”, a oceny łatwo się zawyżają (patrz sekcja o przytakiwaniu). Rubryka z wagami i opisem ocen 1, 3 i 5 zmusza go do porównania tekstu z konkretnym wzorcem. Wagi poniżej odzwierciedlają to, co w reklamie dla sprzedających waży najwięcej: bez hooka nikt nie obejrzy reszty, a bez konkretu nikt nie uwierzy.
| Kryterium (waga) | Pytanie kontrolne | 1 | 3 | 5 |
|---|---|---|---|---|
| Hook, pierwsze 3 s (25%) | Czy pierwsze zdanie zatrzyma osobę, która chce sprzedać mieszkanie? | Powitanie, nazwa biura, „cześć, jestem…” | Temat sprzedaży jest, ale ogólnie | Konkretny problem lub obawa sprzedającego w jednym zdaniu |
| Konkret i wiarygodność (25%) | Czy padają fakty, liczby, miejsca, a nie hasła? | Same przymiotniki („profesjonalnie, szybko”) | Jeden konkret, reszta ogólna | Sprawdzalne szczegóły: dzielnica, proces, czas, co dokładnie robi agent |
| Wezwanie i jakość leada (20%) | Czy widz wie, co zrobić, i czy wezwanie filtruje przypadkowe osoby? | Brak wezwania lub „zapraszamy” | Wezwanie jest, ale nie mówi, dla kogo | Jedno jasne działanie i wskazanie, kto powinien kliknąć |
| Logika i struktura (15%) | Czy argumenty idą w kolejności problem, rozwiązanie, dowód, krok? | Chaos, skoki tematu | Kolejność poprawna, jeden zbędny wątek | Każde zdanie prowadzi do następnego |
| Język do nagrania (15%) | Czy agent powie to naturalnie w 20–45 sekund? | Język ogłoszenia, długie zdania | Da się nagrać po skrótach | Krótkie zdania mówione, zmieści się w czasie |
Przy kryterium hooka przydaje się lista 12 hooków do reklam dla sprzedających jako punkt odniesienia dla oceny 5. Przy logice warto dopisać do promptu, na jakim etapie świadomości sprzedającego jest odbiorca: skrypt dla osoby, która dopiero myśli o sprzedaży, ma inną kolejność argumentów niż skrypt dla kogoś, kto porównuje biura.
Czerwone kartki: kiedy skrypt odpada bez względu na wynik
Niektórych błędów nie nadrobi świetny hook. Dlatego w rubryce działają one jak sufit: niezależnie od średniej ważonej wynik nie może przekroczyć wskazanej wartości. Skrypt z oceną 4,5 i zmyśloną statystyką nadal nie nadaje się do nagrania, a odejmowanie punktów dałoby mu 3,5 i złudzenie, że „wystarczy poprawić drobiazgi”.
Uwaga: to zasady naszej rubryki, a nie cytat z regulaminu reklam Meta. Treści reklam i tak sprawdza platforma, a odpowiedzialność za obietnice w reklamie ponosi biuro. Rubryka ma wyłapać problem, zanim wydasz pieniądze na nagranie.
| Czerwona kartka | Przykład w skrypcie | Sufit oceny |
|---|---|---|
| Błąd merytoryczny lub prawny | „Sprzedamy w 14 dni albo zwrot prowizji”, zmyślona średnia cena | 2,0 |
| Odwołanie do cech osobistych lub straszenie | Zwracanie się do wieku, płci, stanu rodzinnego, pochodzenia, niepełnosprawności; „ceny zaraz runą, sprzedaj dziś” | 2,0 |
| Skrypt niekompletny | Brak wezwania do działania albo urwane zakończenie | 2,5 |
| Nie do nagrania | Sprzeczności w tekście, zdania nie do wypowiedzenia, didaskalia wymieszane z kwestiami, lektor ponad 60 s | 2,0 |
Placeholdery typu {{Miasto}} czy {{Dzielnica}} nie są błędem. Prompt poniżej mówi to modelowi wprost, bo inaczej potrafi obniżyć ocenę za „brak konkretu”.
Gotowy prompt do oceny skryptu reklamy (ChatGPT, Claude, Gemini)
To jest główny artefakt tego poradnika. Skopiuj całość, wklej do nowego czatu i na końcu podmień skrypt. Jeśli nie masz jeszcze tekstów do oceny, zacznij od 4 szablonów skryptu reklamy wideo dla pośrednika i oceń swoje wersje.
Prompt do skopiowania:
Jesteś surowym dyrektorem kreatywnym, który ocenia skrypty reklam wideo dla biur nieruchomości. Reklamy emitujemy w Meta Ads (Facebook, Instagram) jako rolki 20–45 sekund, lektor maksymalnie 60 sekund. Odbiorca to osoba, która rozważa sprzedaż mieszkania lub domu. Celem reklamy jest lead: zostawienie numeru w formularzu.
Oceń poniższy skrypt w skali 1–5 w każdym z pięciu kryteriów. Używaj tylko liczb całkowitych.
- Hook (pierwsze 3 sekundy). 1 = powitanie, nazwa biura, przedstawienie się. 3 = temat sprzedaży jest, ale ogólnie. 5 = konkretny problem lub obawa sprzedającego w jednym zdaniu.
- Konkret i wiarygodność. 1 = same przymiotniki i hasła. 3 = jeden konkret, reszta ogólna. 5 = sprawdzalne szczegóły: miejsce, proces, czas, co dokładnie robi agent.
- Logika i struktura. 1 = chaos, skoki tematu. 3 = kolejność poprawna, jeden zbędny wątek. 5 = problem, rozwiązanie, dowód, krok; każde zdanie prowadzi do następnego.
- Język do nagrania. 1 = język ogłoszenia, długie zdania. 3 = da się nagrać po skrótach. 5 = krótkie zdania mówione, mieści się w czasie.
- Wezwanie i jakość leada. 1 = brak wezwania. 3 = wezwanie jest, ale nie mówi, dla kogo. 5 = jedno jasne działanie i wskazanie, kto powinien zostawić numer.
Sprawdź czerwone kartki i wypisz każdą znalezioną: (a) błąd merytoryczny lub prawny, w tym obietnice wyniku i zmyślone liczby; (b) odwołanie do wieku, płci, stanu rodzinnego, pochodzenia lub niepełnosprawności albo straszenie odbiorcy; (c) skrypt niekompletny; (d) skrypt nie do nagrania: sprzeczności w tekście, zdania nie do wypowiedzenia, didaskalia wymieszane z kwestiami albo lektor dłuższy niż 60 sekund.
Zasady oceny: oceniaj wyłącznie to, co jest w tekście, nie to, co autor „miał na myśli”. Ocena 5 jest rzadka i wymaga spełnienia opisu w całości. Każdą ocenę uzasadnij dosłownym cytatem ze skryptu. Placeholdery w nawiasach, na przykład {{Miasto}}, traktuj jako uzupełnione poprawnie. Nie licz średniej.
Odpowiedz w tym formacie:
- Kryterium: ocena, jedno zdanie uzasadnienia, cytat.
- Czerwone kartki: nazwa i cytat albo „brak”.
- Mocne strony: maksymalnie 3.
- Poprawki: maksymalnie 3, każda z gotowym nowym brzmieniem zdania.
- Werdykt: jedno zdanie.
Skrypt do oceny: [wklej skrypt]
Dwie rzeczy, które robią różnicę. Po pierwsze, średnią ważoną policz sam, w arkuszu albo ręcznie: modele językowe mylą się w arytmetyce i lubią „zaokrąglać w górę”. Po drugie, jeśli masz 2–3 skrypty, które w przeszłości dobrze działały, wklej je nad skryptem do oceny z dopiskiem „to wzorce oceny 4–5”. Model dostaje wtedy kalibrację z twojego rynku.
W ImmoCRM te same kryteria, wagi, sufity czerwonych kartek i progi działają w module Skrypty jako „Ocena skryptu”: model ocenia kryteria z cytatami i proponuje poprawki, a średnią ważoną i sufity czerwonych kartek liczy kod, nie model. Jako kalibracja trafiają tam trzy najlepsze skrypty biura, a ocena stoi obok wyników kreacji z CRM dla biur nieruchomości, w tym hook rate każdej reklamy.
Jak czytać wynik: kiedy nagrywać, poprawiać, odrzucić
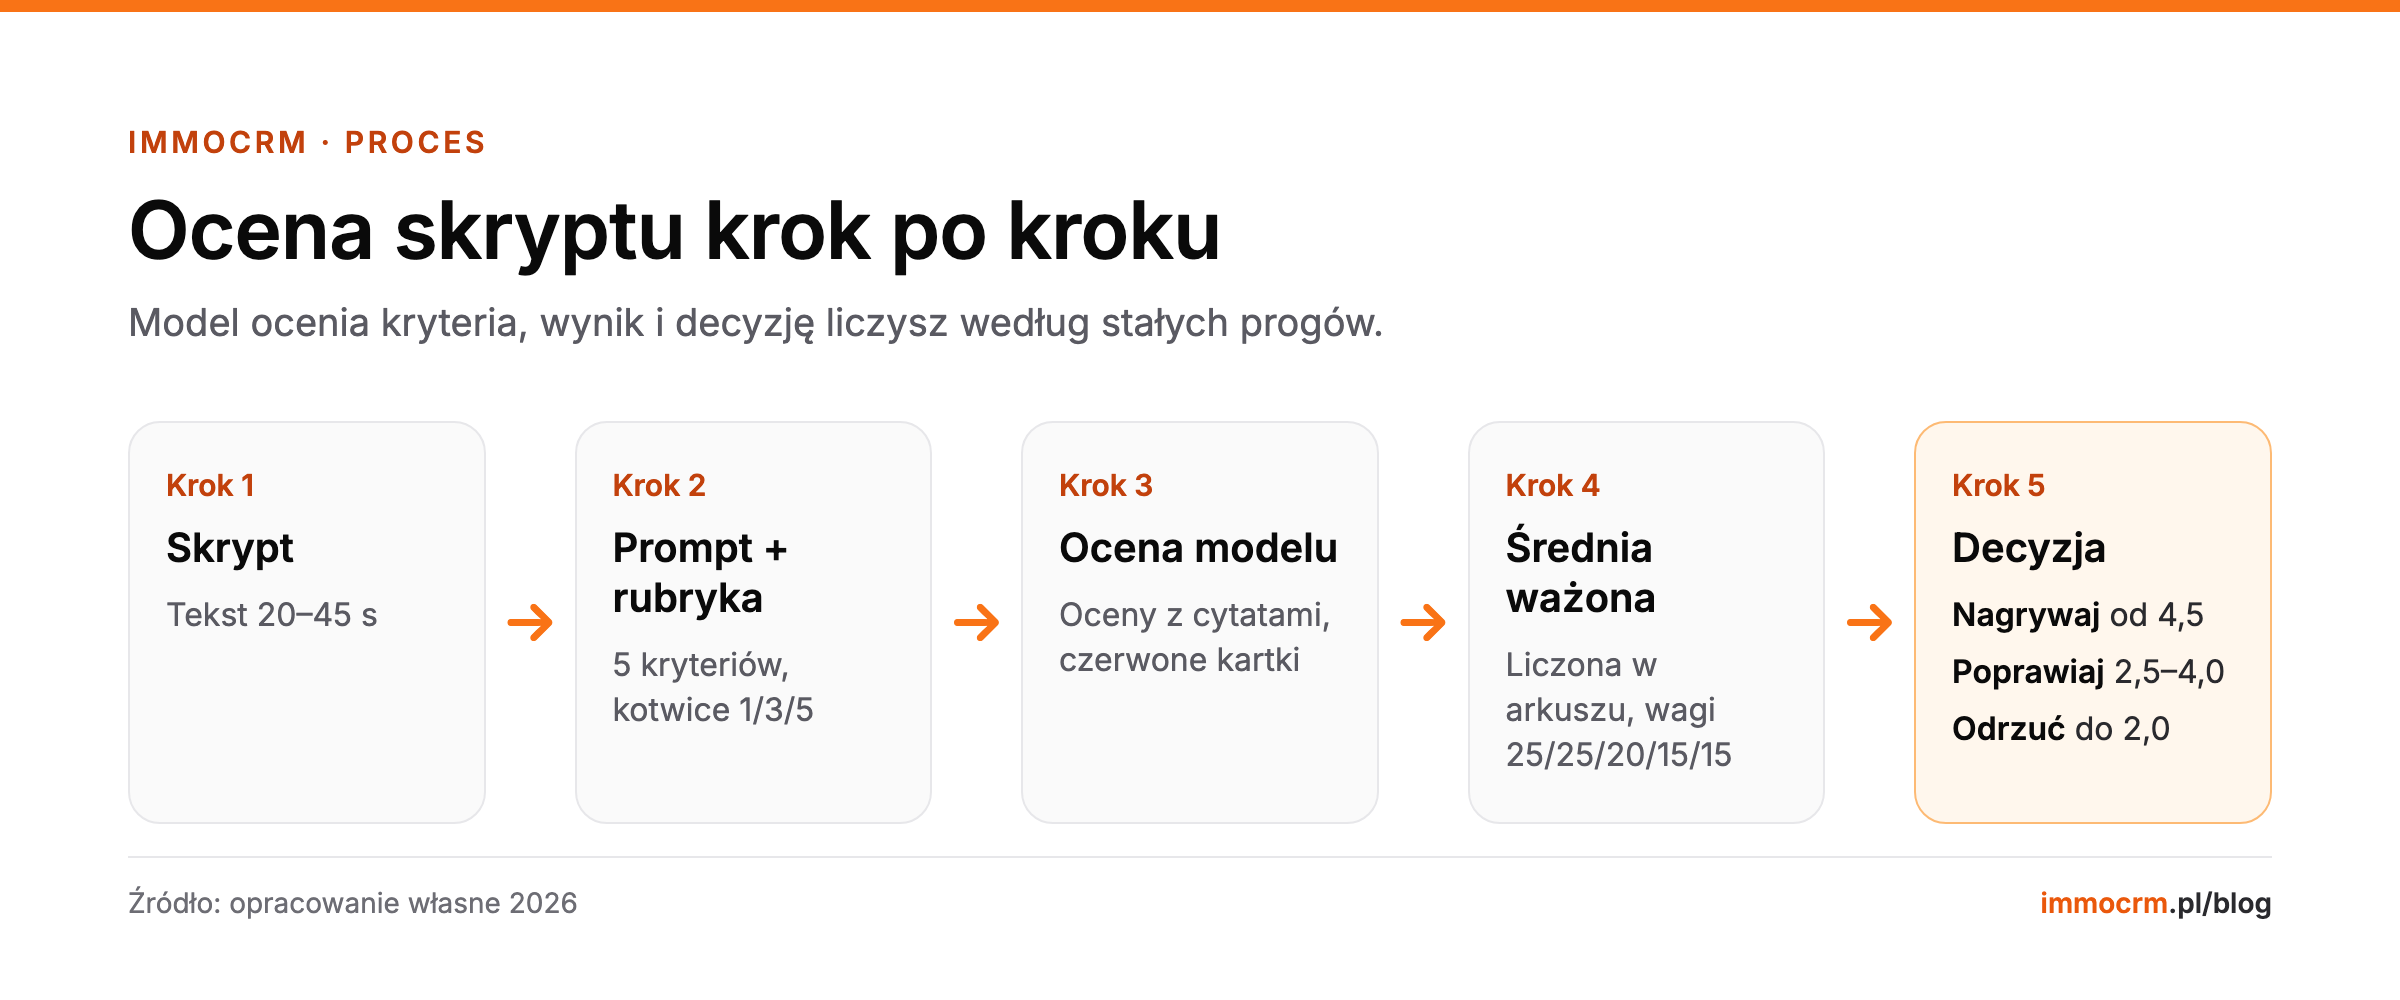
Wynik końcowy to średnia ważona pięciu ocen, przycięta sufitem czerwonej kartki, jeśli się pojawiła, i zaokrąglona do 0,5. Progi decyzji:
| Wynik | Decyzja | Co zrobić |
|---|---|---|
| 4,5–5,0 | Nagrywaj | Skrypt idzie do nagrania bez zmian |
| 3,5–4,0 | Drobne poprawki | Wprowadź poprawki z odpowiedzi modelu, zwykle kwadrans pracy, i nagrywaj |
| 2,5–3,0 | Do poprawy | Wymień hook lub dopisz konkret, potem oceń ponownie w nowym czacie |
| 1,0–2,0 | Odrzuć | Napisz skrypt od nowa, nie łataj |
Przykład obliczenia (dane przykładowe): model wystawił: hook 4, konkret 3, logika 4, język 5, wezwanie 3. Średnia ważona:
0,25 × 4 + 0,25 × 3 + 0,15 × 4 + 0,15 × 5 + 0,20 × 3 = 1,00 + 0,75 + 0,60 + 0,75 + 0,60 = 3,70
Po zaokrągleniu do 0,5 wychodzi 3,5, czyli „Drobne poprawki”. Najtańszy ruch to podniesienie konkretu i wezwania, bo razem ważą 45%. Gdyby ten sam skrypt zawierał obietnicę „sprzedaży w 14 dni”, sufit czerwonej kartki obniżyłby wynik do 2,0 i decyzja brzmiałaby „Odrzuć”, mimo dobrego hooka.
Wagi łatwo ustawić w arkuszu: pięć kolumn z ocenami, szósta z formułą średniej ważonej i zaokrągleniem do 0,5. Arkusz liczy bez pomyłek, a ty widzisz historię ocen wszystkich skryptów w jednym miejscu.
Dlaczego AI chwali twój własny skrypt (i jak temu zapobiec)
Jeśli napiszesz „oceń mój skrypt, pracowałem nad nim cały dzień”, dostaniesz łagodniejszą ocenę. To zjawisko ma nazwę: sycophancy, czyli przytakiwanie użytkownikowi. Badacze z Anthropic w pracy „Towards Understanding Sycophancy in Language Models” (2023, wersja z 2025) sprawdzili 5 asystentów AI w 4 różnych zadaniach tekstowych i wszystkie konsekwentnie przytakiwały użytkownikowi. Autorzy pokazują też, że optymalizacja pod preferencje ludzi potrafi poświęcić prawdziwość na rzecz przytakiwania.
W ocenie skryptów oznacza to zawyżone czwórki i piątki dla tekstu, z którym jesteś emocjonalnie związany. Lista zabezpieczeń:
- Nie pisz „mój skrypt”. Wklejaj tekst jako „skrypt do oceny”, bez informacji, kto go napisał.
- Wymagaj dosłownego cytatu przy każdej ocenie. Ocena bez cytatu jest nieważna.
- Trzymaj się kotwic 1, 3 i 5. Model ma porównać tekst z opisem, nie z „przeciętną reklamą”.
- Oceniaj 2–3 skrypty naraz i każ wskazać najsłabszy. Porównanie trudniej osłodzić niż pojedynczą ocenę.
- Każda ocena w nowym czacie. Wcześniejsza rozmowa zdradza, który tekst lubisz.
- Dodaj 2–3 swoje najlepsze skrypty jako kalibrację, żeby model wiedział, jak wygląda 5 na twoim rynku.
Wskazówka: jeśli model daje 5 w każdym kryterium, prompt jest za miękki, a nie skrypt idealny. Dopisz „ocena 5 jest rzadka” i przetestuj na skrypcie, o którym wiesz, że był słaby.
Test na żywym budżecie: co sprawdzić po starcie
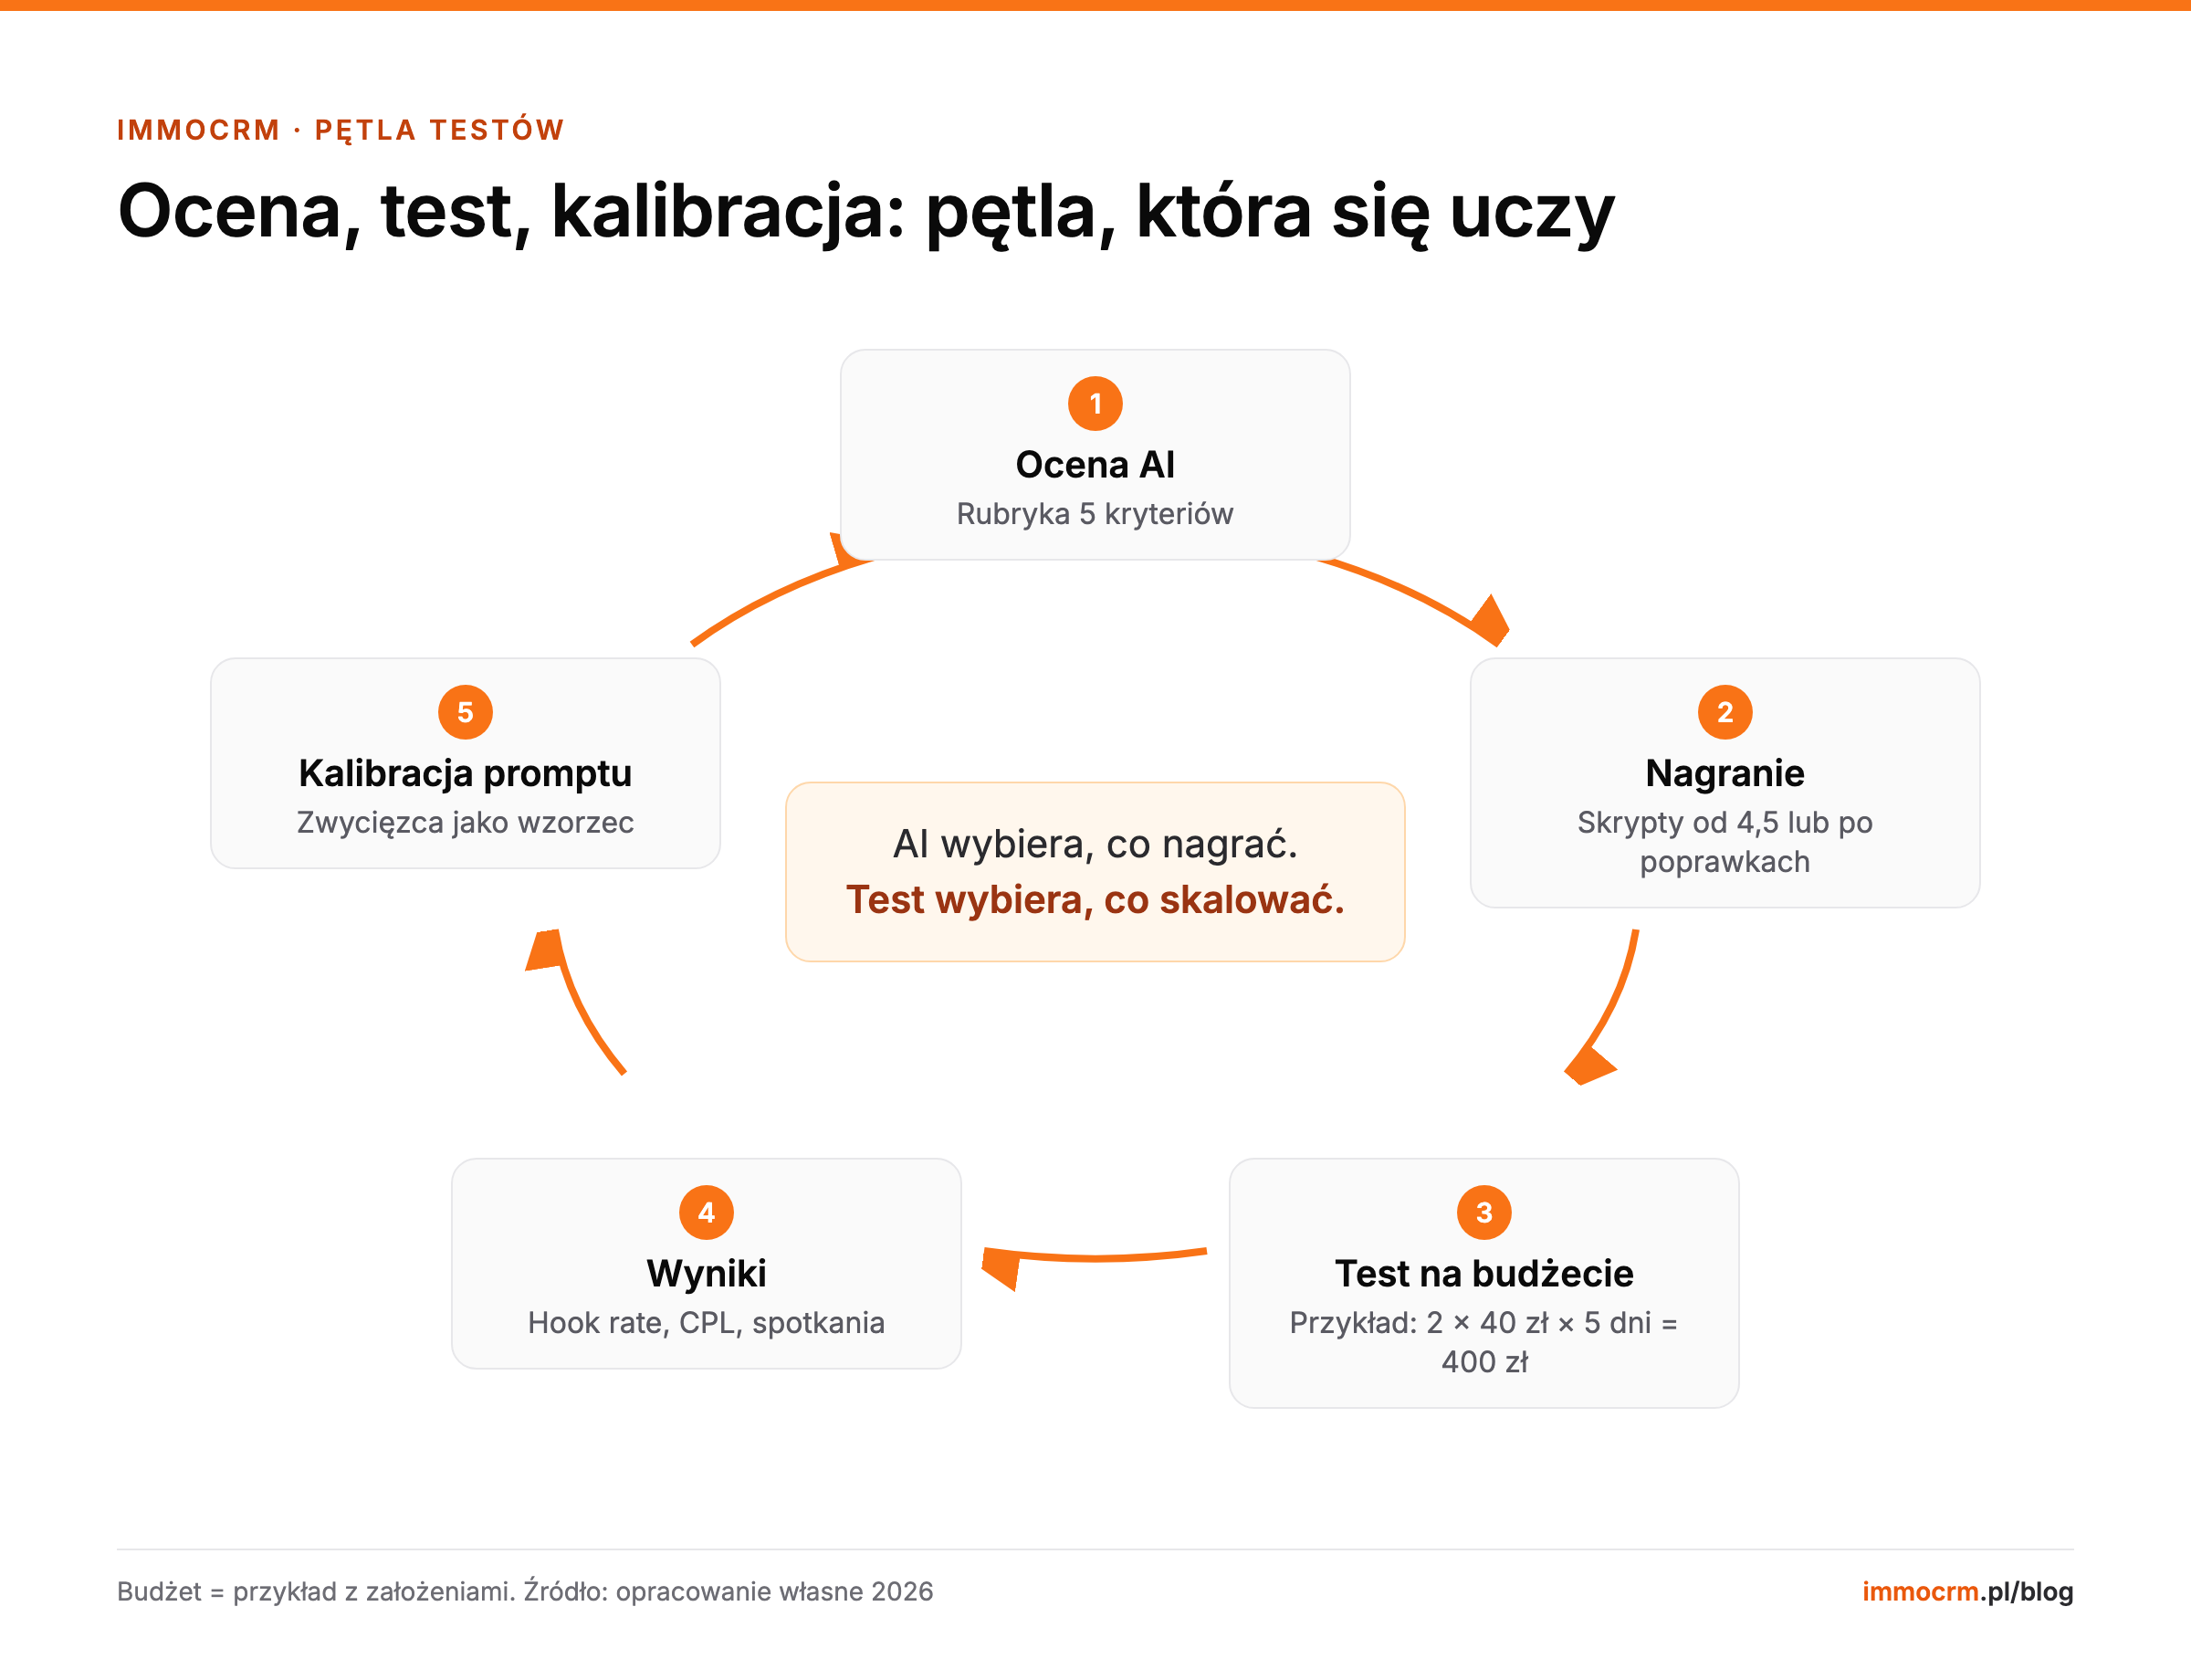
AI wybiera, co nagrać. Test wybiera, co skalować. Po starcie liczą się już wskaźniki z menedżera reklam: jak je czytać, opisaliśmy w poradniku jak mierzyć hook rate i hold rate po starcie, więc tu tylko logika testu.
Przykład budżetu testu (założenia, nie benchmark): dwa skrypty z najwyższą oceną, każdy w osobnej reklamie, 40 zł dziennie na reklamę przez 5 dni. 2 × 40 zł × 5 dni = 400 zł. Ile wydać w twoim mieście i jak rozłożyć budżet miesięczny, opisuje tekst o tym, ile wydać na test reklam w Meta.
Po teście porównuj nie tylko zatrzymania i koszt leada, ale też to, ile leadów zamieniło się w rozmowę i spotkanie pozyskowe. Tani lead, który nie odbiera telefonu, nie jest wygraną. Punkt odniesienia dla kosztu leada i umowy daje raport kosztu leada i umowy pośrednictwa, a jeśli wolisz oddać prowadzenie testów, zobacz, jak wyglądają kampanie Meta Ads dla agencji nieruchomości.
Ostatni krok zamyka pętlę: zwycięski skrypt dopisz do promptu jako wzorzec kalibracyjny. Przy następnej ocenie model porówna nowe teksty z czymś, co naprawdę zadziałało u ciebie, a nie z wyobrażeniem dobrej reklamy. Segwise nazywa ocenę przed startem „only the first half of the loop” i to dobre podsumowanie: druga połowa to dane z rynku.
Najczęstsze pytania
Czy AI przewidzi, która reklama nieruchomości przyniesie najtańszego leada?
Nie. Model językowy ocenia tekst skryptu: hook, konkret, logikę, język i wezwanie do działania. Koszt leada zależy od rzeczy, których w tekście nie ma: grupy odbiorców, stawek w aukcji, pory emisji, jakości nagrania i konkurencji w danym mieście. Nawet dostawcy narzędzi do oceny kreacji przed startem opisują wynik jako potencjał kreacji, a nie prognozę sprzedaży. AI dobrze odsiewa skrypty, których nie warto nagrywać, i wskazuje, co poprawić. Którą reklamę skalować, rozstrzyga dopiero test na żywym budżecie z porównaniem kosztu leada i liczby spotkań.
Jaki prompt wpisać do ChatGPT, żeby ocenił skrypt reklamy?
Prompt powinien zawierać rolę surowego oceniającego, kontekst (Meta Ads, rolka 20–45 sekund, odbiorca sprzedający mieszkanie), pięć kryteriów z opisem ocen 1, 3 i 5, listę czerwonych kartek oraz zasady: oceniaj tylko tekst, piątka jest rzadka, każda ocena z cytatem, placeholdery nie są błędem. Ustal też format odpowiedzi: ocena i uzasadnienie dla każdego kryterium, czerwone kartki, maksymalnie trzy mocne strony i trzy poprawki z nowym brzmieniem, jednozdaniowy werdykt. Średnią ważoną policz sam w arkuszu, bo model łatwo się w niej myli.
Czy ChatGPT może napisać skrypt reklamy dla biura nieruchomości?
Tak, jako pierwszy szkic. Model szybko zaproponuje kilka wersji hooka i struktury, ale zwykle pisze ogólnikami, a czasem dopisuje liczby lub obietnice, których biuro nie może udowodnić. Szkic trzeba więc uzupełnić o lokalne szczegóły: dzielnice, realny przebieg współpracy, to, co agent faktycznie robi dla sprzedającego. Potem sprawdź fakty i przepuść tekst przez rubrykę oceny w osobnym czacie, najlepiej bez informacji, kto go napisał. Pisanie i ocena w jednej rozmowie sprzyjają zawyżonym ocenom.
Czy AI zastąpi test A/B w Meta Ads?
Nie zastąpi, ale zawęzi pole. Bez oceny przed startem biuro testuje skrypty wybrane na wyczucie i płaci za emisję tekstów, które miały oczywiste wady. Z rubryką do testu trafiają dwa lub trzy najmocniejsze skrypty, więc ten sam budżet rozkłada się na lepsze kandydatury. Sam test nadal jest potrzebny, bo tylko on pokazuje hook rate, hold rate, koszt leada i jakość leadów w konkretnej grupie odbiorców. Najlepiej traktować oba kroki jako pętlę: wynik testu wraca do promptu jako wzorzec.
Dlaczego ChatGPT ocenia mój skrypt zbyt wysoko?
Modele językowe mają skłonność do przytakiwania użytkownikowi, nazywaną sycophancy. Badania na kilku popularnych asystentach AI pokazały, że dopasowują one odpowiedzi do przekonań rozmówcy. Jeśli piszesz „mój skrypt” albo wcześniej w rozmowie chwaliłeś tekst, ocena rośnie. Pomaga neutralne wklejenie tekstu jako „skrypt do oceny”, wymóg cytatu przy każdej ocenie, opis ocen 1, 3 i 5, porównywanie kilku skryptów naraz, nowy czat do każdej oceny i dopisek, że piątka jest rzadka.
Ile skryptów oceniać przed testem?
To praktyczna sugestia, a nie wynik badań: oceń od czterech do sześciu skryptów i nagraj dwa lub trzy z najwyższą oceną. Mniej niż cztery daje za mały wybór, więc ocena niewiele zmienia. Więcej niż sześć to zwykle warianty tego samego tekstu, które lepiej porównać już w teście. Liczba nagrywanych skryptów zależy od budżetu: każdy z nich musi dostać tyle emisji, żeby porównanie kosztu leada miało sens. Jeśli budżet jest mały, lepiej przetestować dwa skrypty porządnie niż pięć po trochu.